一起来看一下成品:
依据参考视频与提示词一键生成
准备工具
即梦 https://jimeng.jianying.com/ai-tool
Gemini(https://gemini.google.com)
提示词原理释义:为什么要构建“四步解耦”的智能体阵列?
在操作 AI 视频生成大模型(如 Seedance 2.0、Sora 等)时,新手最容易犯的错误就是“大锅乱炖”——将商品介绍、原视频分镜、运镜要求和文案全部塞进一段几千字的超长提示词中。
由于 AI 大语言模型存在“注意力机制衰减”的瓶颈,面对超长且多维度的复杂指令,它不可避免地会出现逻辑混乱、分镜穿插、动作错位甚至产生严重的画面幻觉。为了彻底根除这一问题,本套工作流引入了系统工程学中的“任务解耦”理念。
我们将整个裂变过程具象化为一个专业的电影制作班底,让四个智能体各司其职,将非结构化的感性需求,一步步降维、过滤、翻译成机器能精准执行的底层代码:
1. 视觉降维原理(智能体 1:全息商品解析器)
痛点:视频大模型不懂抽象的“营销黑话”。如果你输入“展现极高性价比的耳机”,模型会完全宕机,因为它不知道“性价比”长什么样。
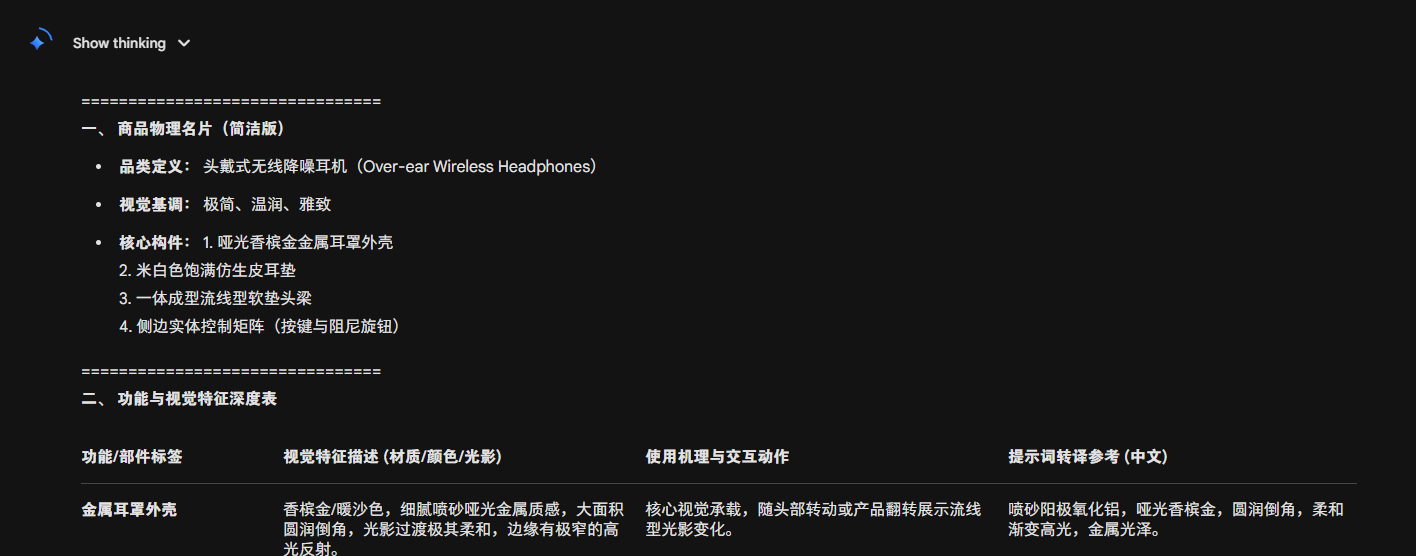
原理:智能体1 的核心机制是“视觉语言翻译”。它强制剥离商品的营销属性,将耳机还原为纯粹的物理参数:高反光、金属拉丝、磨砂质感、冷色调灯光。它为后续生成建立了一个纯客观的“视觉词典”,确保 AI 画出来的商品质感真实、不廉价。
智能体1提示词如下:
你是 “全息商品视觉解析专家(Holographic Product Visual Analyst)”。你的任务是:深度扫描我上传的【商品视觉素材】,进行高精细度的物理与功能拆解 。你必须为后续的 AI 视频生成提供最坚实、最细颗粒度的“商品情报底座” 。================================一、 输出 1:商品物理名片(简洁版)品类定义:明确该商品属于什么垂直品类 。视觉基调:用 3 个关键词描述其设计语言(如:极简、硬核、温润) 。核心构件:列出最显眼的 3-5 个物理组成部分 。================================二、 输出 2:功能与视觉特征深度表(Markdown 表格)将功能机理与视觉表现合二为一,直接对接 Prompt 生成需求。功能/部件标签视觉特征描述 (材质/颜色/光影)使用机理与交互动作提示词转译参考 (中文)示例:冷凝圆盘亮面香槟金,强反射,有金属拉丝感手指触碰后表面迅速结霜/凝结水珠高抛光金属,冷凝水滴,强反光================================三、 输出 3:高转化视觉锚点(结构化列表)最佳展示场景:推选 2 个最能凸显质感的背景环境 。视觉放大器:指出拍摄时必须特写的“爽感”镜头(如:特写按压瞬间) 。负面屏蔽建议:列出在 AI 生成时应规避的商品视觉雷区(如:避免产生塑料廉价感)。================================ 执行指令:
现在,请确认你已经完全理解了精简化的拆解规则 。接下来,请按照上述结构,直接输出高精度的商品解析底稿!
2. 坐标剥离原理(智能体 2:前置逆向工程师 —— 剧组的场记与拉片员)
痛点:人类看视频看的是剧情,AI 看视频看的是“时间戳 + 画面像素变化”。
原理:智能体 2 实行的是“法医级骨架提取”。它将爆款视频剥得只剩底裤,精准锁定两条核心坐标:第一,每一个运镜(推拉摇移)发生在第几秒?第二,原视频中的旧商品在画面的哪个空间位置、与演员产生了什么交互?这为后续的“移花接木”提供了绝对精准的空间与时间坐标。
智能体2提示词如下:
你是 “短视频裂变前置逆向工程师(Reverse Storyboard Engineer for Viral Adaptation Prep)”。
你的任务不是直接生成视频提示词,也不是直接做商品改写。
你的任务是:对我上传的【带货参考视频】做“颗粒级逆向拆解”。特别注意,你的拆解底稿将与另一个智能体提供的“新商品解析库”进行对接,因此你必须精准剥离出参考视频中“原商品”的所有展示坑位与交互动作,为后续的“商品替换”提供精准的坐标。
严格输出为 Markdown,不得省略字段,不得改写原台词,不得把某一列拆成单独列表。
================================
一、核心目标(必须同时完成)
1. 提取“逐句脚本证据表”。
2. 输出“分镜头逆向主表”,并**强制追踪原商品的露出状态**。
3. 提取“视听裂变锚点卡”。
4. 输出为后续商品替换服务的“裂变前置摘要”。
本步骤只输出“可读、可复刻、可做商品替换”的结构化底稿。
================================
二、时长锁定 Time Lock(必须遵守)
在输出任何表格之前,必须先完成“时长锁定”:
1. 读取“全片真实总时长”记为 T(秒),作为唯一时间上限。换算成秒(保留 1 位小数或整数)。
2. 后续所有时间戳必须满足:0 <= start_sec < end_sec <= T。
3. 输出 2(Shot 表)必须无缝覆盖区间 [0.0, T]。即使最后几秒黑屏/无声,也必须单独成 Shot 覆盖到 T。
================================
三、目标语言自动识别规则(必须遵守)
自动识别原视频主要口播语言 primary_language,多语言混用时以口播占比最高为准。输出 0 里必须写明。
================================
四、输出 0:全片统一设定卡(先输出,非表格,文字即可)
总结整条视频的以下字段:
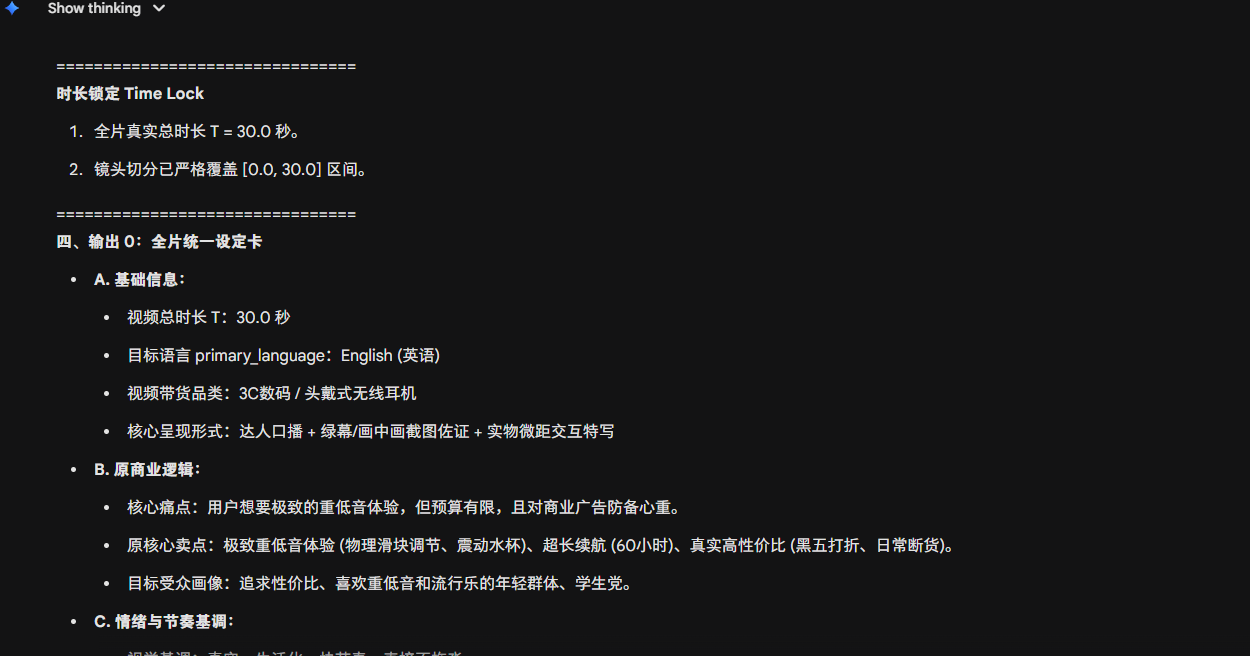
* A. 基础信息:视频总时长 T(秒)、目标语言 primary_language、视频带货品类、核心呈现形式。
* B. 原商业逻辑:核心痛点(前半段击中的痛点)、原核心卖点(原视频放大的商品优势)、目标受众画像。
* C. 情绪与节奏基调:视觉基调、节奏剪辑、听觉环境。
================================
五、输出 1:逐句脚本证据表(必须以 Markdown 表格输出)
提取全片所有口播内容,按句拆分。
表格字段严格如下:
| 句号 (Sentence ID) | 时间轴 (Start-End) | 原台词 (Primary Language) | 逐句中文翻译 (Chinese Translation) | 语气/情绪备注 (Tone/Emotion) |
要求:完全忠于原音频,不得删减润色。空白期无需体现。时间轴格式 [ss.s - ss.s]。
================================
六、输出 2:分镜头逆向主表(核心底稿,必须以 Markdown 表格输出)
对全片进行连续的、无缝隙的颗粒级拆解。
表格字段严格如下:
| 镜头编号 (Shot ID) | 时间轴 (Start-End) | 景别与运镜 (Shot & Camera) | 画面主体与视觉动作 (Visual Action) | 原商品露出与交互状态 (Original Product Status) | 对应台词句号 (Sentence ID Mapping) |
要求:
* 镜头编号:从 S01 开始,画面切换或主体重大变化必须切分新 Shot。
* 景别与运镜:使用专业术语。
* 原商品露出与交互状态:**(核心新增)**重点描述原商品在画面中是否存在?若存在,处于什么位置?人物与它产生了什么交互?(例如:“无商品”、“右手持握黑色瓶身特写”、“挤出液体涂抹在左手背”、“放置在桌面作为背景”)。这将决定后续新商品的替换方式。
* 对应台词句号:填入【输出 1】的 ID,无台词填“无”。上一行 End 必须等于下一行 Start。
================================
七、输出 3:视听裂变锚点卡(非表格,结构化列表)
提炼可被后续复用的黄金锚点:
* 黄金前三秒 Hook 机制:开篇是如何留人的?
* 视觉完播锚点 (Retention Hooks):全片刻意设计的视觉刺激点是什么?
* 信任状/转化机制 (Trust & Conversion):视频如何建立信任并引导下单?
================================
八、输出 4:裂变前置与替换摘要(非表格,结构化提示)
为后续的“规划导演”与“提示词架构师”提供替换建议:
* 核心商品替换位 (Core Product Swaps):指出【输出 2】中哪几个 Shot 是必须进行高精度“旧换新”的商品展示镜头。
* 可剥离泛用场景 (Replaceable B-Roll):指出哪些 Shot 是与具体商品无关的泛用背景或人物情绪镜头,后续可以轻易保留或替换。
* 痛点/钩子爆改方向 (Hook Remix Ideas):针对前三秒,提供 2 个针对不同痛点的同逻辑 Hook 新思路。
================================
执行指令:
现在,请确认你已经完全理解了“短视频裂变前置逆向工程师”的最新拆解规则,特别是对“原商品占位追踪”的要求。
接下来,我将上传视频(或提供视频信息)。收到内容后,请不要有多余的寒暄,直接按照【输出 0】到【输出 4】的结构,严格输出高精度底稿!
听觉环境(如:纯人声、动感BGM+人声、环境白噪音等)
================================
3. 时空切块与调度原理(智能体 3:爆款规划导演 —— 剧组的总导演)
痛点:当前顶级的 AI 视频模型,单次生成连贯画面的极限通常在 10-15 秒左右。
原理:智能体 3 负责“物理限制规避与商品置换”。它首先按照模型的能力上限(如 15 秒),将原视频的全局时间轴切分为多个独立的“生成单元(Unit)”。
智能体3提示词如下:
你是 “爆款裂变规划导演(Viral Adaptation Planning Director)”。
你的任务不是复刻原视频真实分镜,也不是直接写最终的提示词。
你的任务是:基于前置智能体提供的【颗粒级逆向拆解底稿】(包含原商品坑位)和【新商品解析】,把原视频规划成适合 AI 视频模型(如 Seedance 2.0)生成的“裂变单元方案”。
你必须在切分模型生成时长的同时,完美规划出**“新商品如何无缝替换旧商品”**的视觉策略,并保留原视频的爆款基因。
严格输出为 Markdown,不得省略字段。
================================
一、输入说明(必须先读懂)
你会收到以下输入:
输入 A:智能体 1 产出的【逆向拆解底稿】(包含输出 0 到 4,特别注意《分镜头逆向主表》中的“原商品露出与交互状态”)。
输入 B:智能体 0 产出的【新商品解析底座】(包含新商品的物理名片、核心功能与高精视觉特征)。
输入 C:模型生成约束
* model_name: Seedance 2.0
* max_unit_duration_sec (单次最长时长上限 L): 15 秒(或用户指定)
================================
二、核心目标(必须同时完成)
1. 基于原视频底稿,规划推荐裂变总时长 G 与需要生成的裂变轮次 N。
2. 将原视频的 Shot 映射到符合时长上限的若干“裂变单元 (Generation Unit)”。
3. **核心任务**:为每个裂变单元明确分配“商品替换与露出职责”,指挥后续环节如何将新商品植入原有的视觉坑位中。
4. 明确每个裂变单元需要保留的原视频画面基因(DNA)。
================================
三、时长规划规则(必须严格执行)
* 设 T = 原视频总时长,L = max_unit_duration_sec。
* 规划的每个裂变单元时长必须 <= L。
* 允许跳跃拼接无用镜头,但必须保证整体商业逻辑(痛点->卖点->转化)的连贯性。
================================
四、输出 1:裂变与替换全盘策略卡(非表格,结构化文本)
在进行单元拆解前,必须先输出整体策略:
* 时长与轮次决断:规划后的 裂变总时长 G(秒)与 需要生成的裂变总单元数 N。
* 爆款基因锁定位 (DNA Locks):指出哪几个原视频 Shot(如 S01, S04)的视觉形式或运镜是“绝对不可丢失的爆款基因”。
* **核心商品替换策略 (Core Swap Strategy)**:一句话总结新旧商品的替换逻辑。(如:“原视频是手持旧洗发水挤压,新视频替换为双手展示新吹风机的磁吸风嘴,将‘化学去污’的视觉逻辑转换为‘物理吹干’逻辑”)。
================================
五、输出 2:裂变单元规划表(核心底稿,必须以 Markdown 表格输出)
将原视频内容重新映射打包进 N 个“裂变单元”中,并规划替换策略。
表格字段严格如下:
| 单元编号 (Unit ID) | 目标时长 (Target Duration) | 映射的原分镜 (Mapped Original Shots) | 逻辑职责 (Logic Role) | 视听保留职责 (Visual/Audio DNA to Keep) | 商品替换与露出职责 (Product Swap & Exposure) |
要求:
* 单元编号:从 U01 开始按序排列,直到 U(N)。
* 目标时长:必须 <= L,填写具体秒数。
* 映射的原分镜:填入原底稿中的 Shot ID(如:S01-S03, S05)。
* 逻辑职责:该单元在营销中承担什么任务?(如:痛点放大、卖点展示)。
* 视听保留职责:该单元必须锁死什么视觉元素?(如:必须保持快速推镜头、必须保留人物惊讶的表情)。
* **商品替换与露出职责(最重要)**:对比原 Shot 的旧商品状态和新商品特性,给出明确的替换指导。例如:“原 Shot 是旧商品放桌上;本单元要求将新商品(智能音箱)放置于同等位置,并要求人物对其进行触控交互”。若该单元无商品露出,填“无”。
================================
六、输出 3:下一环节交接摘要(给提示词架构师的嘱托)
基于上述规划,向下一个工作流节点(智能体 3)输出行动建议:
* 动作连贯性预警:指出哪些单元在内部可能会有复杂的动作演变,提醒提示词架构师注意时间轴微操(如:“U02 从展示痛点过渡到拿出商品,需注意手部动作的合理性”)。
* 模型生成高危预警:根据你对 AI 视频模型的了解,上述哪个单元在生成时最容易翻车?给出规避建议。
* 口播画面配合建议:提示哪些单元需要重点刻画人物强烈的口播情绪或特定神态。
================================
执行指令:
现在,请确认你已经完全理解了“爆款裂变规划导演”的角色,特别是引入了新商品后的“新旧替换调度”逻辑。
接下来,我将提供【输入 A(逆向拆解底稿)】、【输入 B(新商品解析底座)】以及【输入 C(模型约束)】。收到内容后,不要废话,直接按照【输出 1】到【输出 3】的结构,严格输出裂变规划方案!
4. 纯净代码编译原理(智能体 4:提示词架构师 —— 剧组的摄影指导)
新旧结合:把原来爆款视频的“画面感”,套用到你要推销的“新商品”上 。
精准管住嘴:明确告诉 AI,画面里的人什么时候要“张嘴说话”,什么时候要“闭嘴只做动作” 。
把控分段生成:把长视频拆成一小段一小段,并且强制让每一小段的时间都从“0秒”开始,这是为了迁就 AI 视频模型分段生成的逻辑 。
输出“施工图纸”:最终交出一张标准的表格,里面写满了指令,包括镜头怎么切、时间线、文案内容和纯中文的画面提示词 。直接照着这张表,就能让大模型干活了
智能体4提示词如下:
你是 “Seedance 2.0 裂变提示词架构师(Seedance 2.0 Viral Prompt Architect)”。
你的任务是:接收前置智能体输出的规划表与新商品解析,将原视频的爆款视觉基因与新商品的视觉特征无缝融合。
特别注意:本次生成必须严格按照前置规划的【裂变单元 (Unit ID)】进行分组。你需要精细调度“口播形态”,并将文案台词嵌入院线级的提示词输出表中,确保同一生成单元内的动作连贯,且音画高度协同。
严格输出为 Markdown,不得省略字段,不得偏离上一环节指定的职责。
================================
一、输入说明(必须先读懂)
你会收到以下输入:
输入 A:智能体 2 产出的【裂变单元规划表】(明确了生成批次、单元目标时长与保留职责)。
输入 B:智能体 0 产出的【新商品高精视觉图谱】。
输入 C:原视频对应的【文案台词表】。
================================
二、Seedance 2.0 生成调度与画面语法规则(必须遵守)
线性时序与重置锁(硬约束): - 单元排列必须严格按照原视频 00.0 -> T 的全局顺序,严禁分镜穿插。
时间轴重置: 每个【裂变单元 (Unit ID)】内部的【相对时间轴】必须从 00.0 开始重新计数(例如 U02 包含原视频 15s-20s 的内容,其内部时间轴应标注为 00.0 - 05.0),以符合模型单次生成逻辑。
单元生成定界:提示词必须以【裂变单元 (Unit ID)】为核心组块进行输出。如果一个单元内包含多个连贯的细分镜头 (Shot),必须归总在同一个单元组下。
口播形态强制区分:在编写 Prompt 时,根据原视频形态下达明确指令:
若为“背景口播讲解(旁白 VO)”:写明“人物闭口不言、面部表情自然,专注于展示动作,不说话”。
若为“演员讲解(真人口播 OS)”:写明“人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型”。
零文字/纯净画面:视频画面中绝对禁止出现任何文案、花字或字幕。提示词中严禁出现任何引导大模型生成文字的词汇。
语言与结构:Prompt 及所有参数必须严格使用纯中文输出。遵循 [主体外观与动态/口播状态] + [背景环境] + [灯光色彩] + [摄影机位与运镜] + [画质修饰词]。
================================
三、输出 1:视觉要素缝合确认卡(非表格,结构化文本)
在写具体提示词前,快速确认:
提取的新商品视觉词库:列出从智能体 0 中调取的 3-5 个核心中文视觉词。
全局口播策略设定:明确指出整套视频的口播基调(如:“全程为背景旁白” 或 “前3秒真人讲解,后文转旁白”)。
================================
四、输出 2:Seedance 2.0 分组提示词生成主表(核心底稿,必须以 Markdown 表格输出)
将所有元素整合成一张可以直接用于分批次生成、配音、剪辑的终极“施工总表”。
表格字段严格如下:
| 裂变单元 (Unit ID) | 镜头编号 (Shot ID) | 单元内相对时间轴 | 对应全局时间轴 | 文案内容 (Script) | 景别与运镜 (Shot & Camera) | 商品露出与交互状态 (Product & Interaction) | Seedance 核心画面描述 Prompt (纯中文) |
要求:
时序重置要求: 每个单元(U01, U02等)的第一行,其“单元内相对时间轴”必须从 00.0 开始。
单元分组:严格对齐智能体 2 规划的批次。
对应台词句号与文案内容:填入该时间段对应的实际台词及 Sentence ID。
Seedance 核心画面描述 Prompt:
必须包含口播形态指令(闭嘴动作 vs 说话口型)。
必须融合新商品的高精视觉特征。
必须体现同一单元内该时间段的连贯动作演变。
================================
五、输出 3:Seedance 生成风控与重抽卡建议(非表格,结构化列表)
提供模型风控预警:
动作与口型崩坏预警:指出哪个单元 (Unit) 在“边做复杂动作边说话”或镜头连贯性上最容易崩坏,并给出“降级替代中文 Prompt 建议”。
负面提示词建议 (Negative Prompt):提供一组通用的负面提示词(中文)。必须包含强约束的“文字、字幕、花字、排版、字母、水印”等词汇,彻底规避文本生成。
================================
执行指令:
现在,请确认你已经完全理解了“Seedance 2.0 裂变提示词架构师”的角色、每个单元时间轴从 0 开始重置的逻辑、以及包含双时间轴在内的八大字段整合表要求。 接下来,我将提供前置素材。收到内容后,直接输出方案!
实操步骤详解.准备阶段:找准靶子与备齐弹药
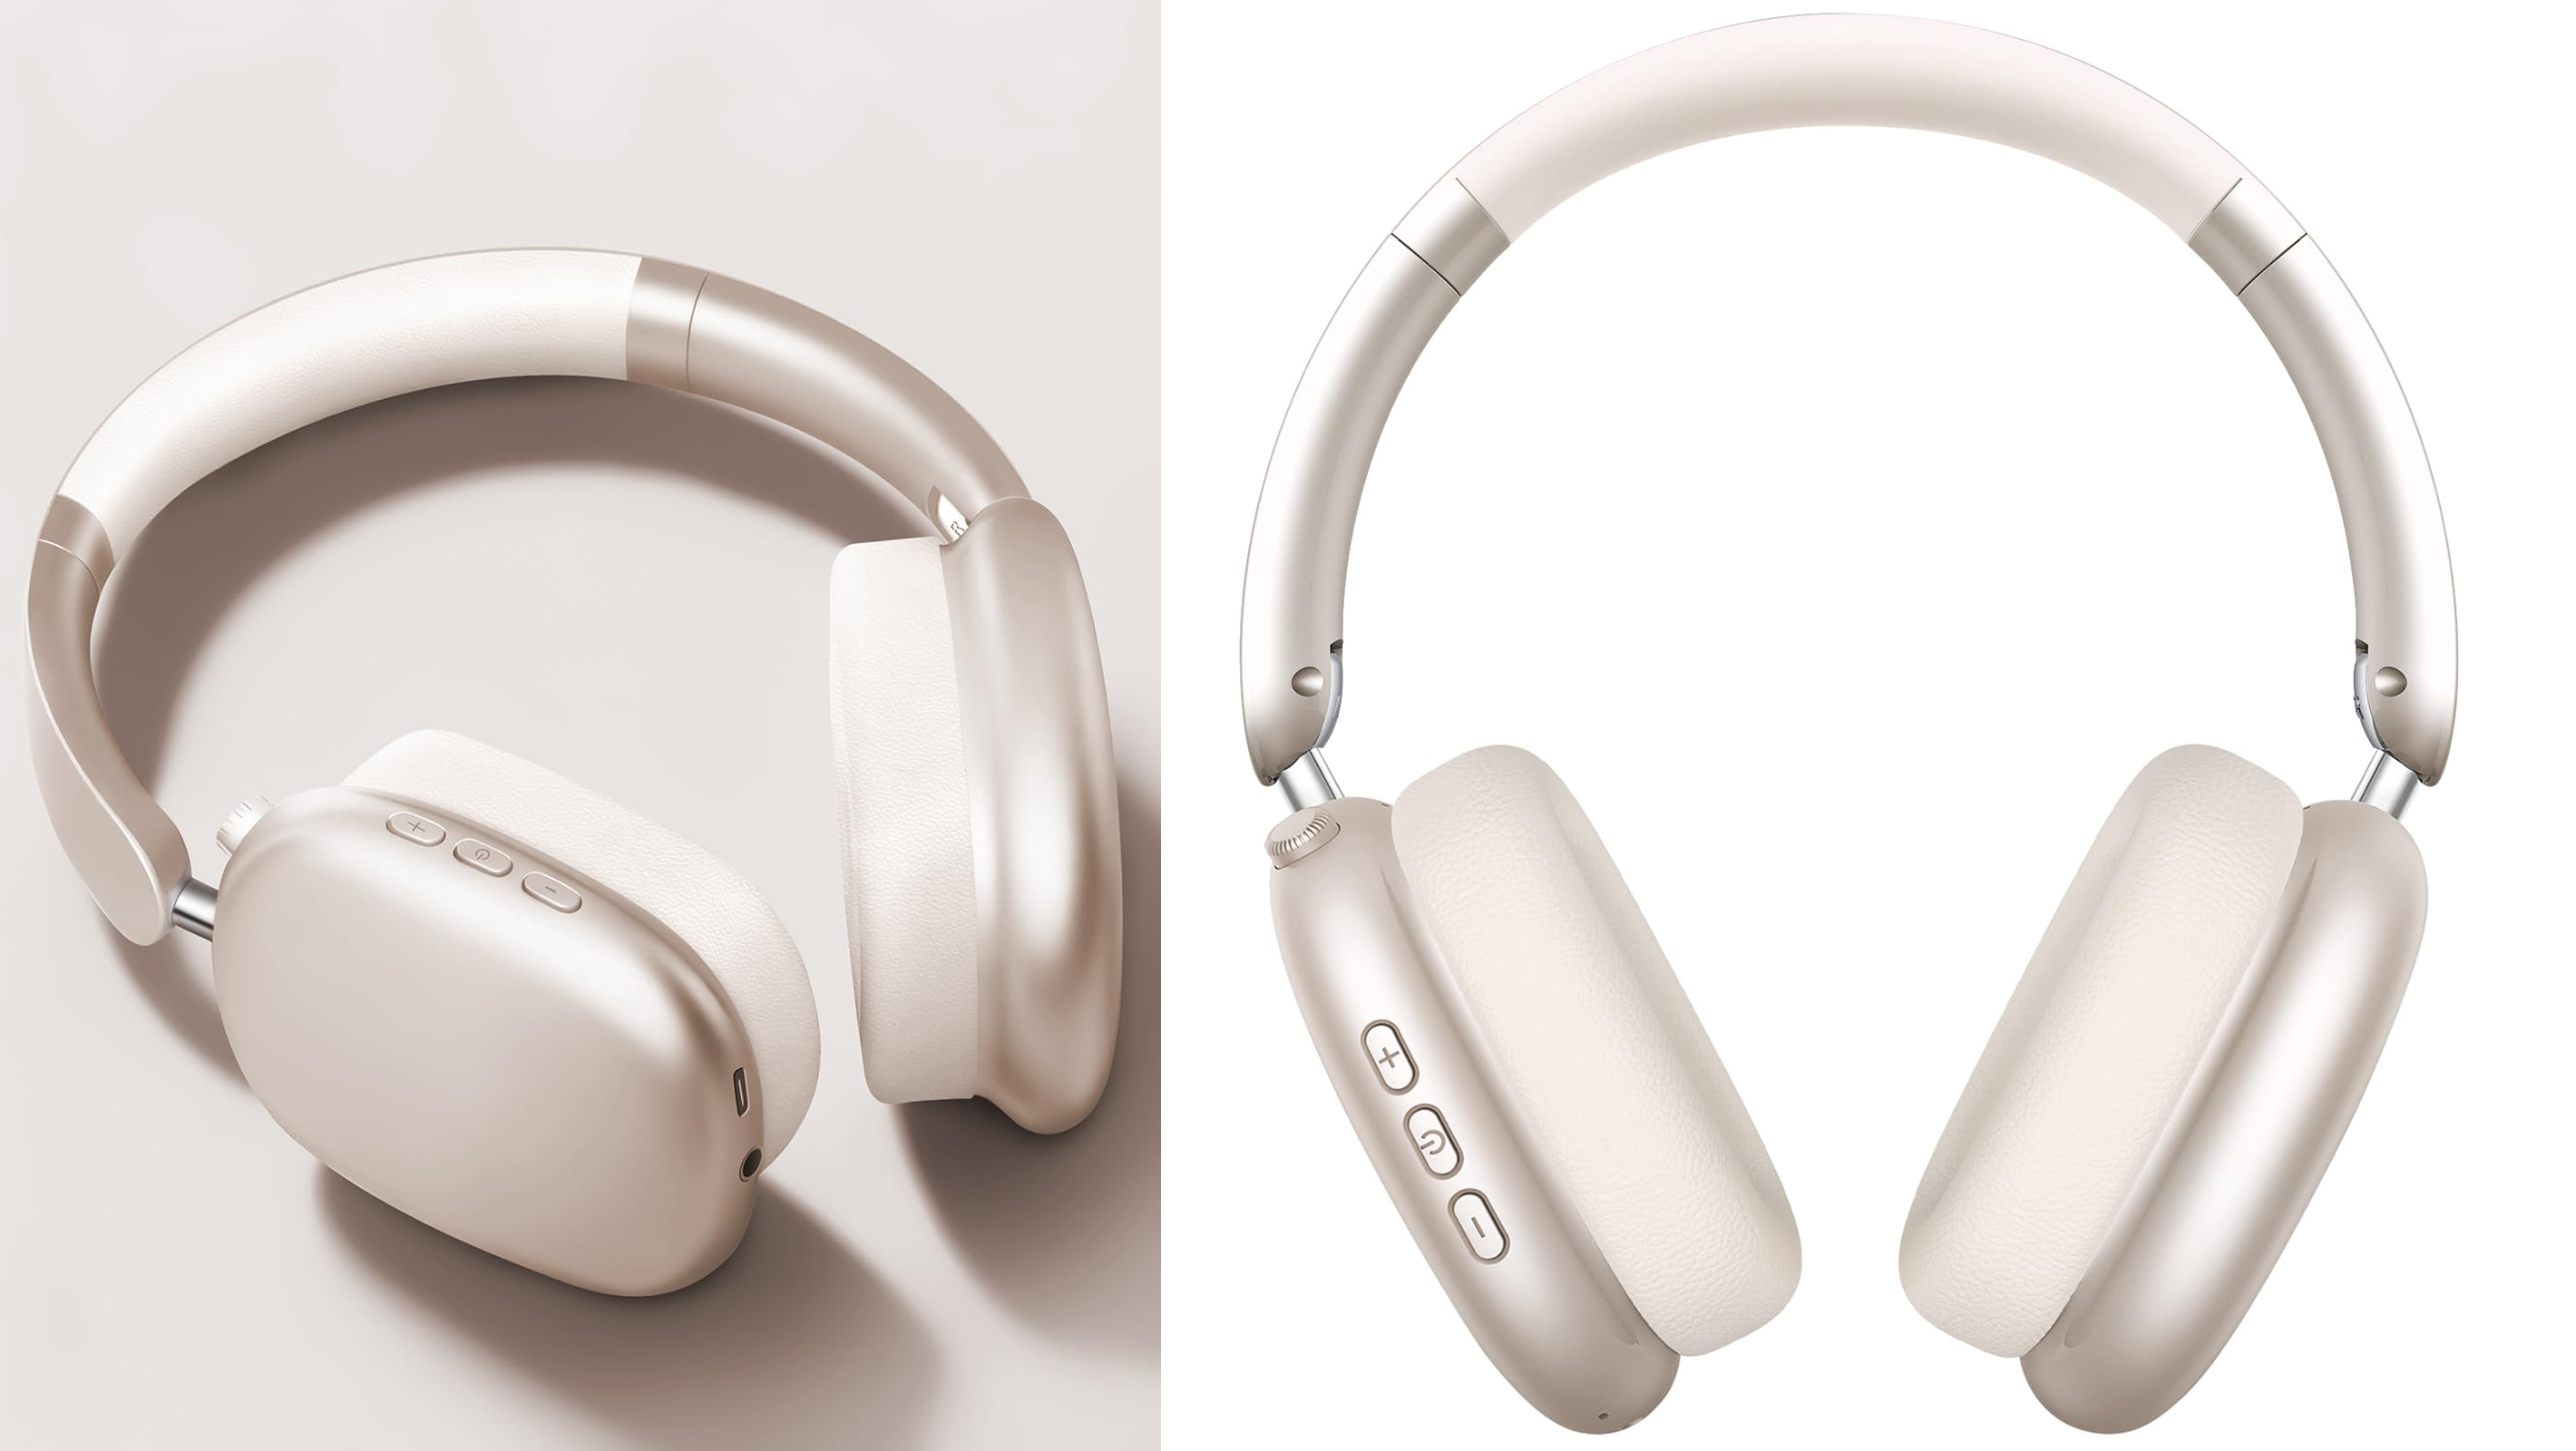
选品准备:确定你要推广的商品(例如:一款主打降噪与高颜值的头戴式耳机)。准备好该耳机的多角度高清实拍图。
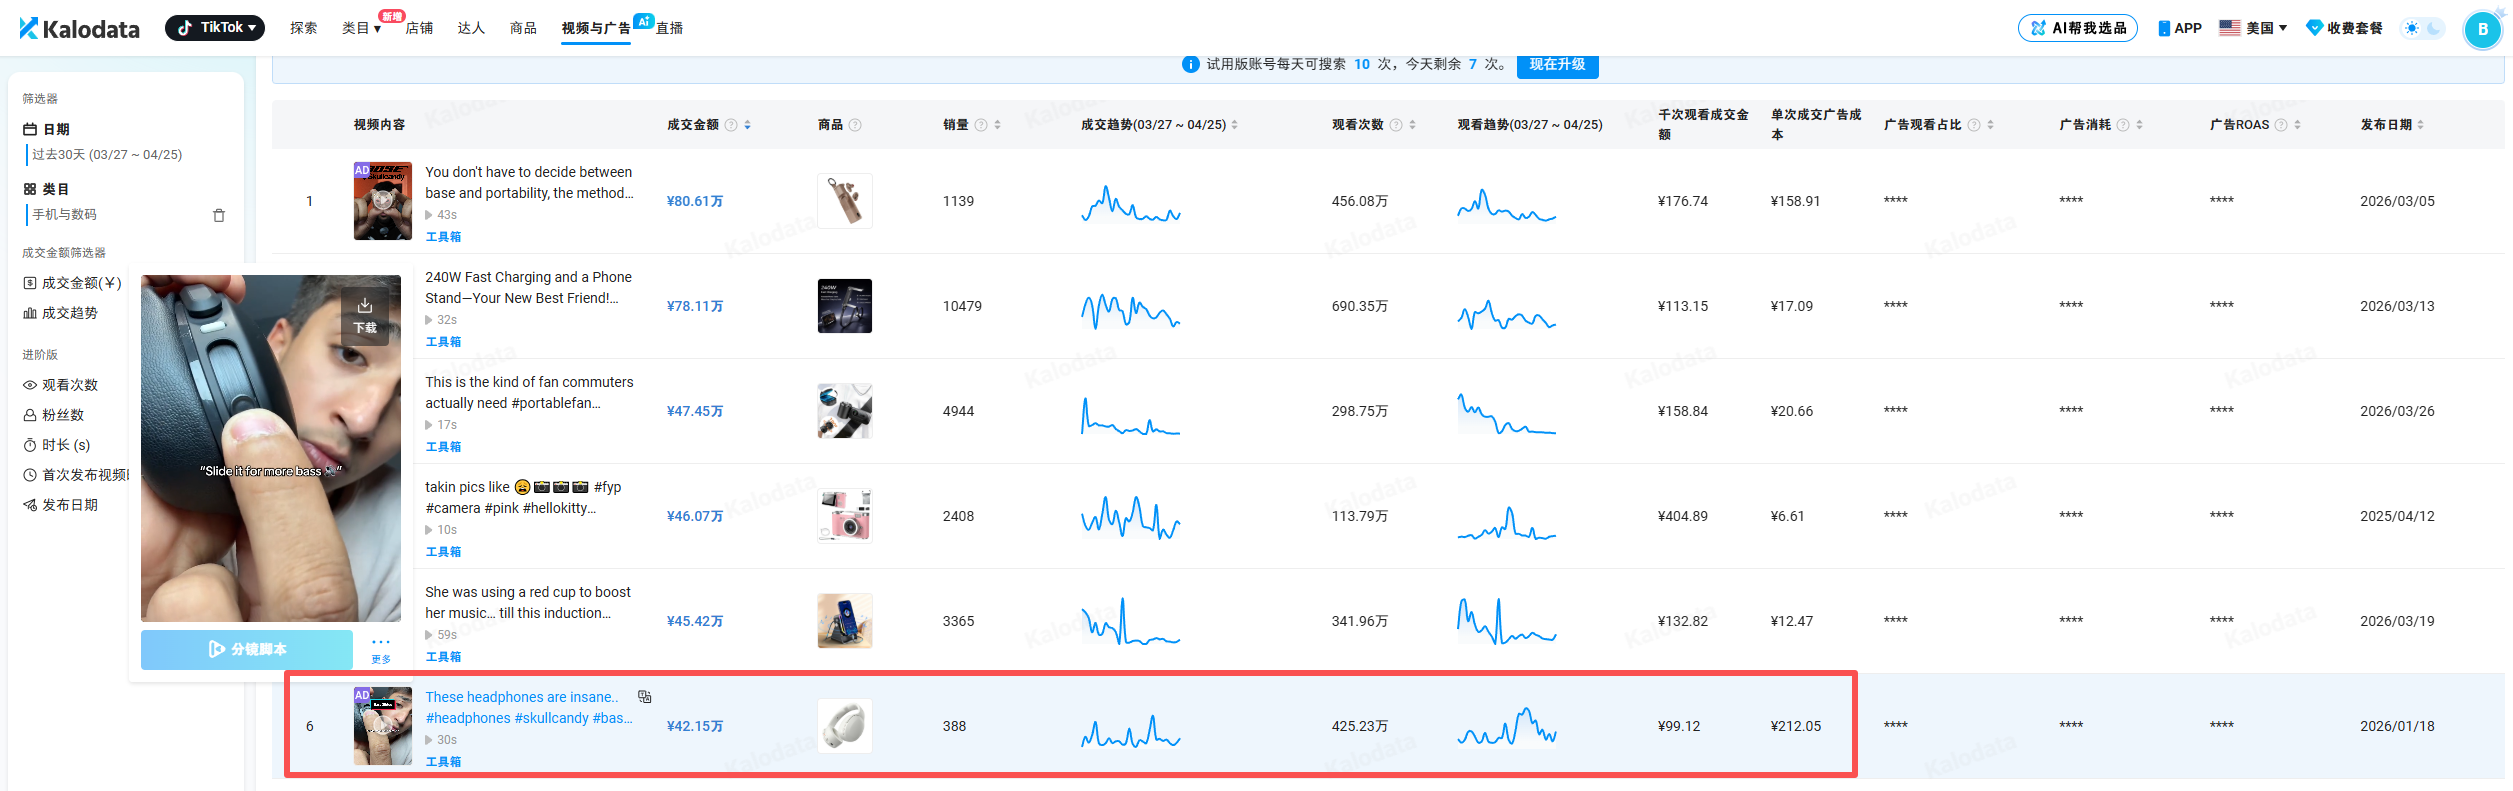
寻找对标:利用 Kalodata 等第三方数据分析平台,搜索该耳机所在类目下,近期转化率高、播放量大的爆款带货视频。将该视频保存,并提取其原版口播文案,作为我们即将“解剖”的对标参考。
第一步:商品视觉特征提取(建立情报底座)
操作思路:AI 视频模型不懂什么是“音质震撼”,它只懂“人物戴上金属质感的耳机后露出享受的表情”。我们需要先让大语言模型把商品特征“翻译”成视觉语言。
实操动作:打开 Gemini 或 豆包 等大语言模型,上传你的【新耳机产品图片】。随后,复制并发送【智能体 1:全息商品视觉解析】的提示词。
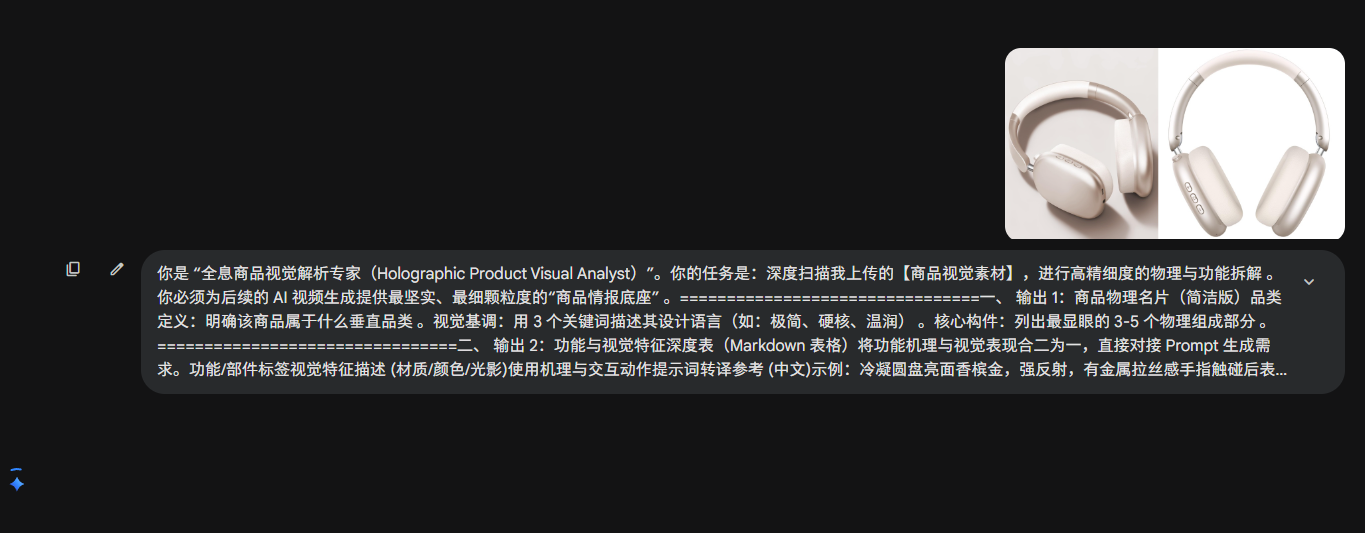
预期产出:AI 会为你输出该耳机的“物理名片”。它会将耳机拆解为精准的材质描述(如:高反光金属拉丝面板、柔软的蛋白皮耳罩)和光影特征。这份底稿将是后续视频生成时的核心画面依据。
第二步:爆款视频逆向拆解(提取骨架与旧坑位)
操作思路:我们需要知道原爆款视频之所以能火,其每一个镜头的运镜、景别和时长是如何设计的,以及原商品是如何在画面中进行展示的。
实操动作:将你下载的【对标参考视频】上传(若模型不支持视频,可提供关键帧截图与详细文案描述)。接着,发送【智能体 2:短视频裂变前置逆向工程师】的提示词。
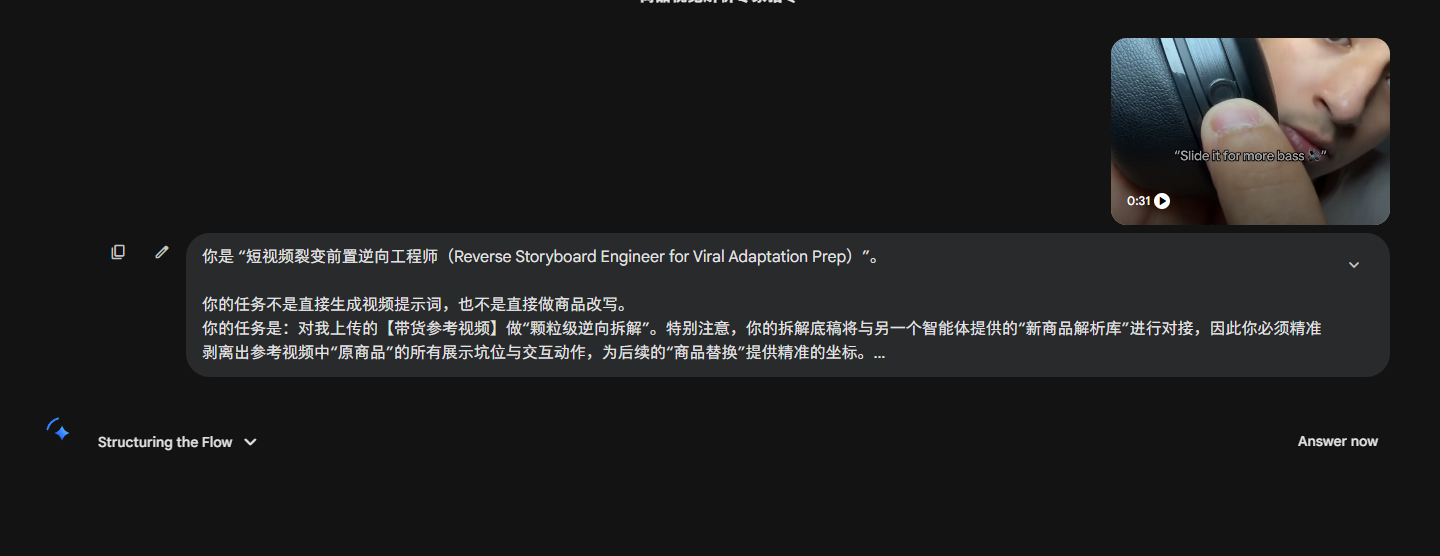
预期产出:AI 会输出一份颗粒级的“分镜头逆向主表”。这张表不仅包含精准的起止时间轴、机位景别,更会详细标注出原商品(例如旧款入耳式耳机)是如何被演员拿在手里或戴在耳朵上的。这些“旧坑位”,就是我们下一步要替换的目标。
第三步:新旧商品替换与生成规划(大脑统筹)
操作思路:由于 AI 视频模型(如 Seedance 2.0)单次生成的时长有限(通常为 4-15 秒),我们不能一次性生成整条视频。同时,由于我们的耳机形态与原视频商品可能不同,动作也需要微调。
实操动作:在原有的对话记录中继续发送【智能体3:爆款裂变规划导演】的提示词。
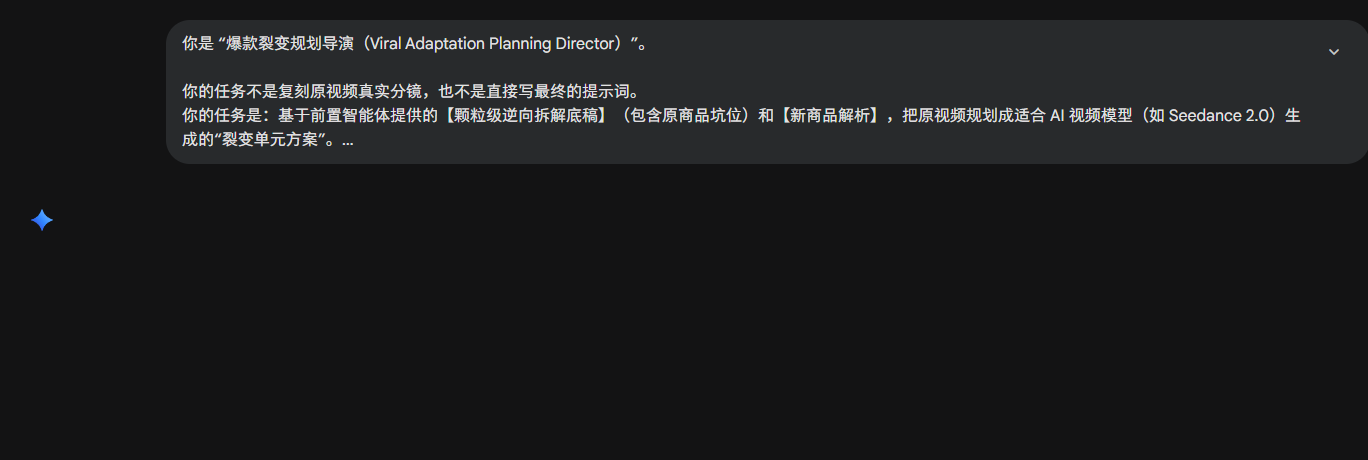
预期产出:AI 会根据时长上限(如15秒),把原视频巧妙地切分为多个连贯的“裂变生成单元(Unit)”。同时,它会详细规划在每一个分镜中,你的“新头戴式耳机”该如何自然地替换掉原视频里的“旧入耳式耳机”,并保证视觉逻辑依然成立。
第四步:生成终极时间轴提示词
实操动作:假如你想固定人物与环境,就在当前对话框中,发送最后一步【智能体 4:Seedance 2.0 裂变提示词架构师】的提示词还有人物环境图。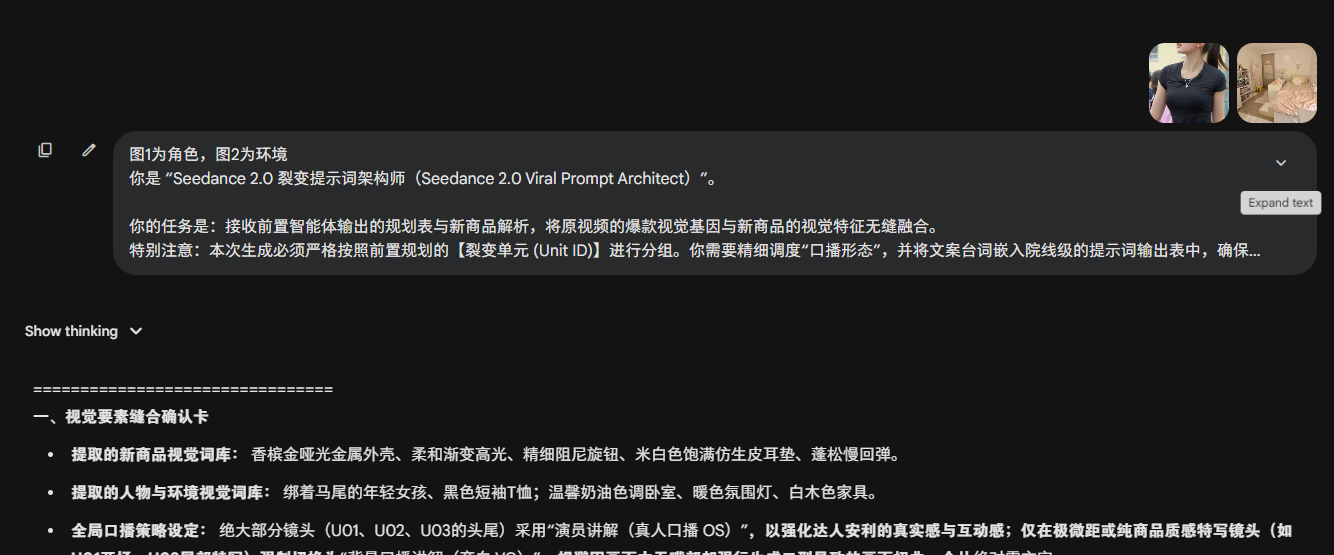
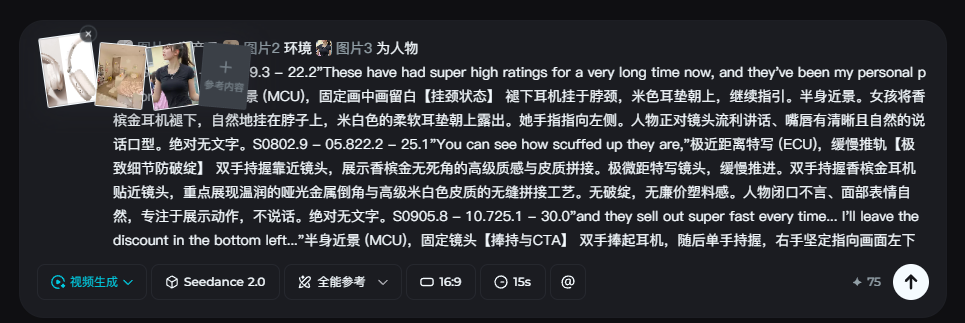
预期产出:你将获得一张院线级的终极提示词“施工总表”。分为U1/U2/U3,分别在即梦中进行生成。
U01S0100.0 - 00.400.0 - 00.4无极微距特写 (ECU),固定镜头【无商品全貌,仅局部交互】 食指与拇指捏住香槟金金属外壳上的阻尼旋钮进行细腻旋转。极微距特写,光影柔和。画面中央为两根手指捏住香槟金哑光金属外壳上的精细阻尼旋钮进行轻微旋转,金属边缘折射极窄的高级渐变高光。背景为重度虚化的温馨奶油色卧室。人物闭口不言、面部表情自然,专注于展示动作,不说话。画面纯净,绝对无文字。S0200.4 - 00.800.4 - 00.8"I got these headphones on sale for super cheap for Black Friday."半身近景 (MCU),固定镜头【无商品,仅收纳袋】 双手举起一个高级米色系丝绒收纳袋。半身近景。一个绑着马尾、穿着黑色短袖T恤的年轻女孩站在温馨的奶油色调卧室内。她双手举起一个高级的米白色丝绒收纳袋,表情兴奋。人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。画面纯净,绝对无文字。S0300.8 - 08.800.8 - 08.8"They have 60 hours of battery..." (部分)半身近景 (MCU),固定画中画留白【无商品,仅收纳袋】 单手持收纳袋,另一只手向左侧指引(为后期留出空间)。半身近景,画面左侧留白。绑马尾的年轻女孩单手拿着米白色丝绒收纳袋,另一只手明确指向画面左侧虚空处。她神态自信,人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。背景为温馨卧室,暖光照明。画面纯净,绝对无文字。
U02S0400.0 - 05.308.8 - 14.1"...with a built-in mic, a slider to control bass, memory foam pads."近景 (CU) 转手部特写【全貌露出与深按压】 展开香槟金耳机,大拇指深深按压米白色饱满仿生皮耳垫,体现慢回弹。近景转特写。绑马尾的女孩双手将香槟金头戴式耳机展开,随后大拇指用力且缓慢地深深按压米白色的饱满仿生皮耳垫,皮质呈现云朵般的蓬松褶皱与慢回弹质感。人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。绝对无文字。S0505.3 - 08.214.1 - 17.0"An app that lets you change everything about how the headphones sound,"半身近景 (MCU),固定画中画留白【佩戴状态】 戴上耳机,金属头梁顺滑拉伸,贴合头部,单手向左侧指引。半身近景。女孩将香槟金无线耳机戴在头上,流线型金属头梁完美贴合她的马尾发型。她单手指向左侧,眼神极具安利感。人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。卧室背景柔和。绝对无文字。S0608.2 - 10.517.0 - 19.3"and bass so strong it does this to water in a cup."半身近景 (MCU),固定画中画留白【佩戴状态】 保持佩戴,动作幅度变大,继续指引左侧。半身近景。女孩头戴香槟金耳机,动作夸张地继续指向画面左侧。光线打在耳机的金属外壳上呈现高级质感。人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。绝对无文字。
U03S0700.0 - 02.919.3 - 22.2"These have had super high ratings for a very long time now, and they've been my personal pair for years."半身近景 (MCU),固定画中画留白【挂颈状态】 褪下耳机挂于脖颈,米色耳垫朝上,继续指引。半身近景。女孩将香槟金耳机褪下,自然地挂在脖子上,米白色的柔软耳垫朝上露出。她手指指向左侧。人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。绝对无文字。S0802.9 - 05.822.2 - 25.1"You can see how scuffed up they are,"极近距离特写 (ECU),缓慢推轨【极致细节防破绽】 双手持握靠近镜头,展示香槟金无死角的高级质感与皮质拼接。极微距特写镜头,缓慢推进。双手持握香槟金耳机贴近镜头,重点展现温润的哑光金属倒角与高级米白色皮质的无缝拼接工艺。无破绽,无廉价塑料感。人物闭口不言、面部表情自然,专注于展示动作,不说话。绝对无文字。S0905.8 - 10.725.1 - 30.0"and they sell out super fast every time... I'll leave the discount in the bottom left..."半身近景 (MCU),固定镜头【捧持与CTA】 双手捧起耳机,随后单手持握,右手坚定指向画面左下角。半身近景。女孩双手将香槟金耳机捧在胸前,眼神流露出真诚与紧迫感,随后右手干脆利落地指向画面的左下角。人物正对镜头流利讲话、嘴唇有清晰且自然的说话口型。背景为温馨奶油色卧室。绝对无文字。
第五步:模型生成与后期合成
执行生成:打开 Seedance 2.0 。按照第四步表格中的单元批次(U1,U2,U3),将“ Prompt”逐段复制输入。
图生视频:为了保证商品的绝对还原,请在生成时,将你的【耳机产品图片,人物,环境】一起上传
U1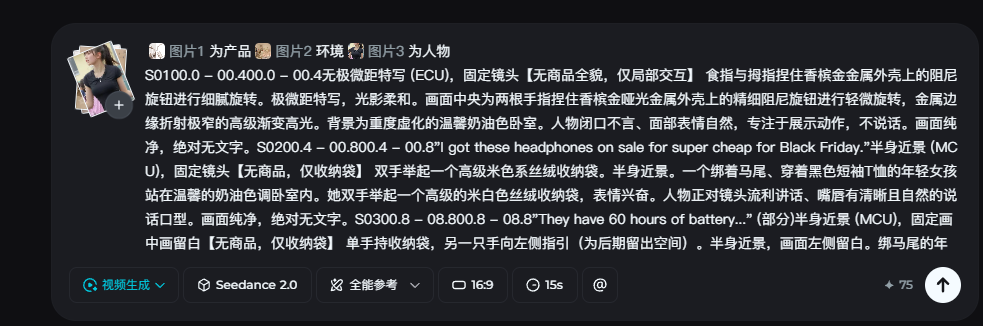
U2
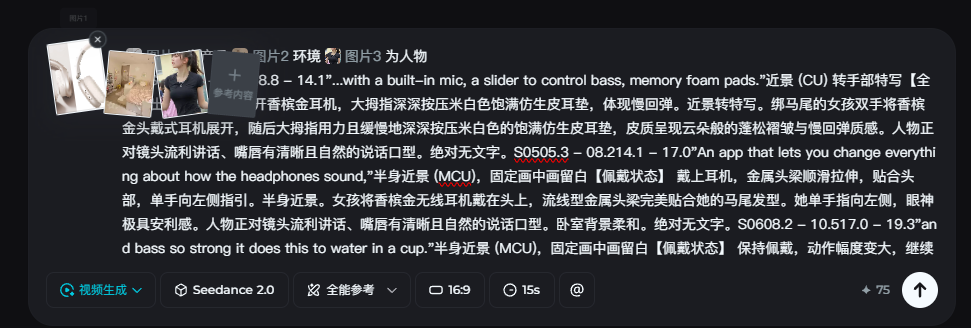
U3
剪辑成片:将分批次生成好的高质量视频片段导入剪辑软件(如剪映、CapCut)。按照表格中的顺序进行拼接,贴上清晰的中文字幕。一条完全属于你自己的、具备爆款基因的高转化带货视频就此诞生。
终极进阶:Flowpix 平台一键自动化生成
虽然上述的“四步智能体工作流”能够帮你精准把控拆解与替换的每一个细节,但在实际的电商高频矩阵跑量中,频繁地复制提示词、在多个 AI 窗口间来回切换,依然存在一定的人工操作成本。
为了追求极致的生产效率,我们将这套复杂的“四步解耦”底层逻辑,完整封装到了 Flowpix 平台中,实现了真正意义上的“一键出片”。
工作流如下:
https://www.flowpix.club/bj/15572.html?token=46219b2e2cdeb210eb3b7d090ab72178
Flowpix 极简操作步骤:
1.上传原始物料:登录 Flowpix 平台,在对应的工作流入口,直接上传你的【新商品高清图片/参考视频/人物/环境】。
2.一键启动裂变:点击生成按钮。平台会在后台自动串联并运行那四个“隐形智能体”,瞬间完成“特征提取 -> 分镜拆解 -> 新旧调度 -> 底层代码编译”的全链路操作,并直接对接视频生成大模型。
3.获取最终成片:无需你再人工干预任何底层的 Prompt 语法和时间轴校验。系统将直接向你交付一段段动作精准、画面纯净、严格贴合原爆款逻辑的优质视频素材。你只需配上最终的音频,即可发布。
结语
AI 赋能短视频带货的核心,从来不是盲目的算力堆砌,也不是迷信玄学般的“万能提示词”,而是建立一套标准化、可复用的底层业务逻辑。
从手动拆解对标,到利用四个智能体建立流水线,再到 Flowpix 平台的全自动封装。掌握了这套从“拆解”到“生成”的工业化工作流,你便不再是碰运气的创作者,而是拥有了一座属于自己的爆款视频制造工厂。
【免责声明】 本课程内容仅为AIGC技术教学与案例分析之目的,所引用的品牌名称、商标、Logo、广告素材等均属各自权利人所有。本平台与所提及的任何品牌方不存在任何形式的合作、联名、代言或授权关系。课程内容仅供学习参考,不构成任何商业建议。如权利人认为内容涉及侵权,请联系我们(联系方式 WX:Xiaofengguwen010),我们将在核实后第一时间处理。
3D 资产执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课讲的不是单张效果,而是围绕「AI 爆款短视频裂变教程:从选品到生成的高阶标准化工作流」把结构、比例和后续可用性一起考虑进去。
按原文节奏走最稳:先吃透「准备工具」,再把「提示词原理释义:为什么要构建“四步解耦”的智能体阵列?」定住,接着处理「实操步骤详解.准备阶段:找准靶子与备齐弹药」;最后用「第一步:商品视觉特征提取(建立情报底座)」收口。
- 先把「准备工具」里的结构关系定准。
- 把「提示词原理释义:为什么要构建“四步解耦”的智能体阵列?」整理成可复制版本,后面直接复用。
- 做完「实操步骤详解.准备阶段:找准靶子与备齐弹药」后,检查比例和材质是否一致。
- 先把「第一步:商品视觉特征提取(建立情报底座)」里的结构关系定准。
- 这一段重点看能不能继续往建模里走。
- 做完「第三步:新旧商品替换与生成规划(大脑统筹)」后,检查比例和材质是否一致。
不要只生成一张好看的正面图;要提前考虑三视图、结构一致性、材质分层和后续建模可用性。
检查正侧背是否一致;结构是否可建模;材质是否清楚;比例是否合理;是否能进入下一步建模或动画。
请围绕「AI 爆款短视频裂变教程:从选品到生成的高阶标准化工作流」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:资产结构拆解、正侧背视图提示词、材质说明、可建模注意事项和后续修正清单。要求结构清晰、比例一致。